자료구조를 들어야 알고리즘을 들을 수 있고, 라이브러리 A를 빌드해야 B를 빌드할 수 있습니다. 이렇게 먼저 해야 하는 일이 정해진 작업들을 모순 없이 한 줄로 세우는 것이 위상 정렬입니다. 정보처리기사 그래프 문제, 프로젝트 일정 관리(선후행 관계)와 연결되는 토픽입니다.
위상 정렬은 방향 그래프의 모든 간선 방향을 지키는 정점 순서
정의: 방향 비순환 그래프(DAG)에서 모든 간선 u → v에 대해 u가 v보다 앞에 오도록 정점을 나열하는 것입니다. 사이클이 있으면 위상 정렬은 존재하지 않습니다.
- 핵심 키워드: DAG, 진입 차수(In-degree), 카흔 알고리즘, DFS 후위 순서, 사이클 판별
- 결과는 하나가 아닐 수 있음: 동시에 시작할 수 있는 정점이 여럿이면 여러 정답이 가능합니다.
카흔 알고리즘은 진입 차수 0인 정점부터 꺼낸다
- 모든 정점의 진입 차수(들어오는 간선 수)를 센다.
- 진입 차수가 0인 정점을 큐에 넣는다.
- 큐에서 정점을 꺼내 결과에 추가하고, 그 정점에서 나가는 간선을 지우며 도착 정점의 진입 차수를 1씩 줄인다.
- 새로 진입 차수가 0이 된 정점을 큐에 넣고, 큐가 빌 때까지 반복한다.
- 결과에 들어간 정점 수가 전체보다 적으면 사이클이 있는 것이다.
선수 과목 예시로 직접 따라가 보기
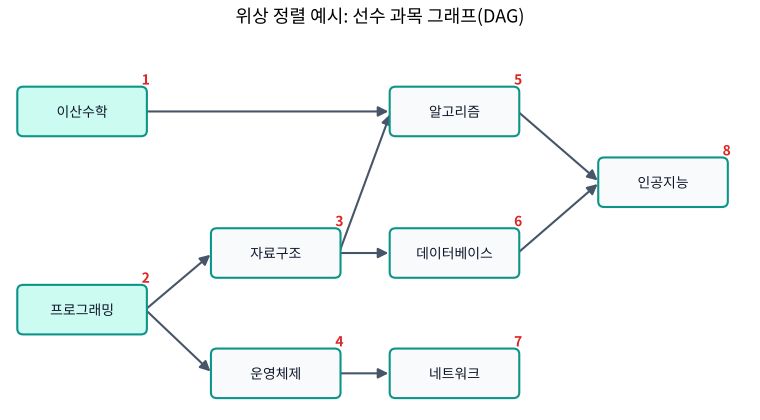
| 단계 | 꺼낸 정점 | 진입 차수가 0이 되어 큐에 들어간 정점 |
|---|---|---|
| 초기 | – | 이산수학, 프로그래밍 |
| 1 | 이산수학 | 없음(알고리즘은 아직 1) |
| 2 | 프로그래밍 | 자료구조, 운영체제 |
| 3 | 자료구조 | 알고리즘, 데이터베이스 |
| 4 | 운영체제 | 네트워크 |
| 5 | 알고리즘 | 없음(인공지능은 아직 1) |
| 6 | 데이터베이스 | 인공지능 |
| 7~8 | 네트워크, 인공지능 | – |
결과는 이산수학 → 프로그래밍 → 자료구조 → 운영체제 → 알고리즘 → 데이터베이스 → 네트워크 → 인공지능입니다(코드로 검산). 큐에 넣는 순서를 바꾸면 프로그래밍을 먼저 꺼내는 등 다른 정답도 가능합니다.
카흔 방식과 DFS 방식 비교
| 구분 | 카흔(Kahn, 1962) | DFS 기반 |
|---|---|---|
| 원리 | 진입 차수 0인 정점을 큐로 처리 | DFS 종료 순서(후위)를 뒤집음 |
| 사이클 판별 | 처리된 정점 수가 V보다 적으면 사이클 | 탐색 중 방문 중인 정점을 다시 만나면(역방향 간선) 사이클 |
| 복잡도 | O(V+E) | O(V+E) |
| 장점 | 동시에 시작 가능한 작업 묶음을 단계별로 파악하기 쉬움 | 재귀로 간결하게 구현 |
답안에서 놓치기 쉬운 포인트
- 위상 정렬은 정렬 알고리즘(퀵·병합 정렬)과 무관한 그래프 알고리즘입니다.
- 무방향 그래프나 사이클이 있는 그래프에는 정의되지 않는다는 전제를 꼭 쓰세요.
- 활용: 빌드 시스템의 의존성 해결, 패키지 설치 순서, 스프레드시트 셀 재계산 순서, 프로젝트 일정의 선후행 관계(CPM 계산의 전 단계).
시험 직전 한 줄 요약
위상 정렬은 DAG에서 간선 방향을 지키는 정점 순서이며, 카흔 알고리즘은 진입 차수 0인 정점을 큐로 꺼내 O(V+E)에 구하고, 남는 정점이 있으면 사이클입니다.
학습용 정리이며 실제 시험 문항과 다를 수 있습니다. 출제 기준은 큐넷 공지를 확인하세요. 그림은 이해를 돕기 위한 개념도와 예시입니다.