“인덱스를 만들었는데 왜 안 타요?” SQL 튜닝에서 가장 자주 나오는 질문이다. 답을 알려면 인덱스가 어떤 모양으로 정렬되어 있는지부터 봐야 한다. SQLD의 SQL 최적화 기본 원리 단원과 정보관리기술사 데이터베이스 영역에서 인덱스 구조와 “인덱스를 사용하지 못하는 경우”는 단골 주제다.
인덱스는 책 뒤편의 찾아보기처럼 정렬된 키와 위치 정보를 따로 모아 둔 구조다
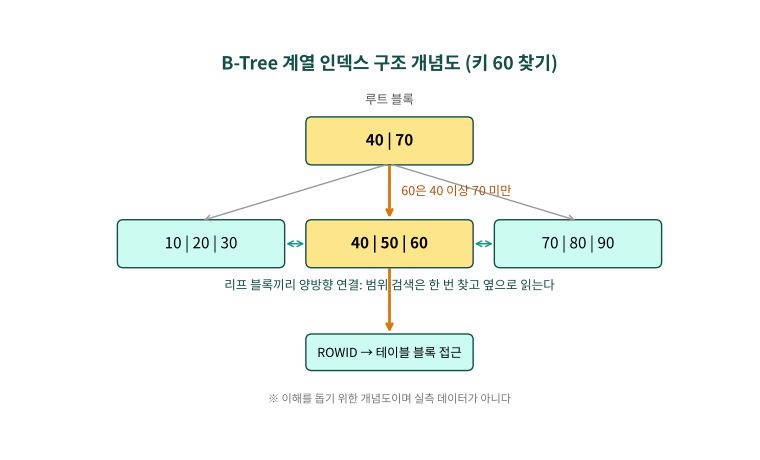
책에서 “트랜잭션”이라는 단어를 찾을 때 첫 쪽부터 넘기지 않고 찾아보기에서 쪽수를 확인한다. 인덱스도 같다. 키 값을 정렬해 두고, 각 키가 가리키는 행의 위치(Oracle에서는 ROWID)를 함께 저장한다. 대부분의 RDBMS가 기본으로 쓰는 인덱스는 B-Tree 계열(실제 구현은 B+Tree 변형이 많다)이다.
- 핵심 키워드: 루트·브랜치·리프 블록, 균형 트리, 리프 블록 연결, ROWID, 클러스터형·비클러스터형
- 균형(Balanced): 어떤 키를 찾든 루트에서 리프까지의 깊이가 같다.
검색은 루트에서 리프까지 한 길로 내려가고, 리프 블록은 서로 연결되어 있다
- 루트 블록의 키와 비교해 어느 자식 블록으로 내려갈지 정한다.
- 브랜치 블록에서 같은 비교를 반복해 리프 블록에 도착한다.
- 리프 블록에서 키를 찾고, 함께 저장된 ROWID로 테이블 블록을 읽는다.
- 범위 조건이면 리프 블록의 연결 순서를 따라 옆으로 계속 읽다가 조건을 벗어나는 지점에서 멈춘다.
인덱스가 만드는 속도 차이는 읽는 블록 수로 계산하면 감이 온다
다음처럼 가정해 보자. 테이블에 1억 행이 있고 한 블록에 100행이 들어가며, 인덱스 블록 하나에 키가 약 200개 들어간다. 숫자는 설명을 위한 가정이다.
- 풀 스캔: 1억 ÷ 100 = 100만 블록을 읽는다.
- 인덱스 깊이: 200의 3제곱은 800만, 4제곱은 16억이므로 1억 건은 4단계로 충분하다(log200 1억 ≈ 3.48, 올림하면 4).
- 한 건 조회: 인덱스 4블록 + 테이블 1블록 = 약 5블록. 100만 ÷ 5 = 20만 배 차이다.
다만 조회 행이 많아지면 얘기가 달라진다. 인덱스로 읽은 행마다 테이블 블록에 랜덤 접근이 생기므로, 처리 범위가 넓으면 풀 스캔이 더 빠를 수 있다. 그 기준선은 DBMS와 데이터 분포에 따라 다르다.
정렬된 키 값 자체를 건드리는 조건은 인덱스 시작점을 찾지 못한다
| 인덱스를 못 쓰는 조건 | 이유 | 고치는 방향 |
|---|---|---|
WHERE SUBSTR(name,1,1)='김' 처럼 컬럼에 함수 적용 |
인덱스는 원래 컬럼 값으로 정렬되어 있어 가공된 값은 정렬 순서가 다름 | name LIKE '김%' |
WHERE sal*12 > 36000000 |
좌변 컬럼을 연산함 | sal > 3000000 (상수 쪽으로 연산 이동) |
LIKE '%김' 처럼 앞쪽 와일드카드 |
첫 글자가 정해지지 않아 어느 지점부터 읽을지 알 수 없음 | 검색 요건 재검토, 별도 검색 설계 |
| 문자 컬럼을 숫자와 비교하는 묵시적 형변환 | 컬럼 쪽이 변환되면 컬럼 가공과 같은 결과가 됨(DBMS별 규칙 상이) | 비교 대상의 타입을 컬럼에 맞춤 |
부정 조건(<>, NOT IN) |
범위를 좁혀 주지 못해 대부분 읽게 됨 | 가능하면 긍정 조건으로 변환 |
| 결합 인덱스의 선두 컬럼 조건 누락 | 정렬이 선두 컬럼 기준이라 뒤 컬럼만으로는 위치를 특정할 수 없음 | 선두 컬럼 조건 추가, 컬럼 순서 재설계 |
NULL도 함정이다. Oracle의 단일 컬럼 B-Tree 인덱스는 모든 키가 NULL인 행을 저장하지 않아 IS NULL 조건에 쓰이지 못하는 경우가 있다. 제품마다 동작이 다르므로 시험에서는 “DBMS에 따라 다르다”는 단서를 붙이는 편이 안전하다.
결합 인덱스는 컬럼 순서가 곧 성능이다
(부서코드, 입사일) 순서로 만든 인덱스를 생각해 보자. 부서코드가 같은 행끼리 모여 있고 그 안에서 입사일 순으로 정렬된다. 그래서 부서코드='A' AND 입사일 BETWEEN ...은 좁은 구간만 읽지만, 입사일 조건만 있으면 부서마다 흩어져 있어 효율이 떨어진다. 일반적으로 등치(=) 조건 컬럼을 앞에, 범위 조건 컬럼을 뒤에 두고, 조건에 자주 쓰이는 컬럼을 우선한다.
답안에는 구조 설명과 사용 불가 조건, 그리고 인덱스의 비용을 함께 쓴다
- 구조 → 검색 과정 → 인덱스 비효율 조건 → 설계 원칙 순서가 읽기 편하다.
- 인덱스는 공짜가 아니다. INSERT·UPDATE·DELETE 때 인덱스도 함께 갱신되어 쓰기 비용과 저장 공간이 늘어난다. 읽기 위주 컬럼에 선택적으로 만든다.
- 선택도(서로 다른 값의 비율)가 낮은 컬럼은 인덱스 효과가 작다. 다만 값이 몇 종류뿐인 컬럼에는 비트맵 인덱스가 쓰이기도 한다.
시험 직전 한 줄 요약
인덱스는 정렬된 키로 한 길을 내려가 찾는 구조이므로, 키 컬럼을 가공하거나 선두 컬럼을 건너뛰면 그 정렬을 쓸 수 없다.
이 글은 학습용 정리이며 실제 시험 문항과 다를 수 있다. 출제 기준은 한국데이터산업진흥원, 큐넷 등 공식 공지를 확인하라. 그림은 개념도이며 실측 데이터가 아니다.