
환자 1,000명 중 암 환자가 20명뿐인 데이터로 모델을 만들었는데 정확도가 98%라면 훌륭한 모델일까? 안타깝게도 “모두 정상”이라고만 답해도 98%가 나온다. 사기 탐지, 불량 검출, 질병 진단처럼 찾아야 하는 쪽이 드문 문제에서 흔히 생기는 함정이다. 빅데이터분석기사 분류 모델링과 정보관리기술사 인공지능 영역에서 불균형 데이터 처리 기법은 반복해서 다뤄진다.
불균형 데이터에서 정확도는 다수 클래스만 맞혀도 높게 나온다
1,000건 중 정상 980건(98%), 이상 20건(2%)인 데이터를 가정하자. 모든 입력을 정상으로 예측하면 정확도는 980÷1,000=98%다. 하지만 이상을 하나도 찾지 못하므로 재현율(Recall)은 0%다. 그래서 불균형 데이터에서는 정확도 대신 재현율, 정밀도, F1, PR-AUC 같은 지표를 함께 본다.
- 핵심 키워드: 클래스 불균형, 다수·소수 클래스, 언더샘플링, 오버샘플링, SMOTE, 클래스 가중치, 임계값 조정
- 평가 원칙: 검증·시험 데이터는 원래 분포를 유지한다.
해결 방법은 데이터를 바꾸는 방법, 학습을 바꾸는 방법, 판정 기준을 바꾸는 방법으로 나뉜다
| 기법 | 원리 | 장점 | 한계 |
|---|---|---|---|
| 랜덤 언더샘플링 | 다수 클래스 표본을 덜어냄 | 간단하고 학습이 빨라짐 | 유용한 정보를 버릴 수 있음 |
| 랜덤 오버샘플링 | 소수 클래스 표본을 복제해 늘림 | 정보 손실이 없음 | 같은 표본을 반복해 과적합 위험 |
| SMOTE | 소수 표본과 이웃 사이에 새 표본을 합성 | 복제보다 다양한 표본 생성 | 경계가 겹친 곳에서 잡음 표본 생성, 범주형 변수에는 별도 변형 필요 |
| 클래스 가중치 | 소수 클래스 오류에 더 큰 손실을 부여 | 데이터를 바꾸지 않음 | 모델·라이브러리 지원 여부에 따라 다름 |
| 임계값 조정 | 확률 0.5 대신 상황에 맞는 기준 사용 | 재학습 없이 적용 가능 | 정밀도와 재현율이 맞교환됨 |
어느 하나가 정답은 아니다. 데이터가 충분히 크면 언더샘플링이 빠르고, 소수 표본이 적으면 SMOTE나 가중치가 유리한 경우가 많다. 결국 같은 검증 데이터에서 여러 방법의 재현율과 정밀도를 비교해 고르는 것이 가장 확실하다.
SMOTE는 소수 표본과 가까운 이웃을 잇는 선분 위에 새 점을 만든다
- 소수 클래스 표본 x를 하나 고른다.
- 같은 클래스에서 x와 가까운 k개의 이웃 중 하나(x’)를 무작위로 고른다.
- 0과 1 사이의 난수 λ를 뽑아 새 표본 = x + λ(x’ − x)를 만든다.
- 원하는 비율이 될 때까지 반복한다.
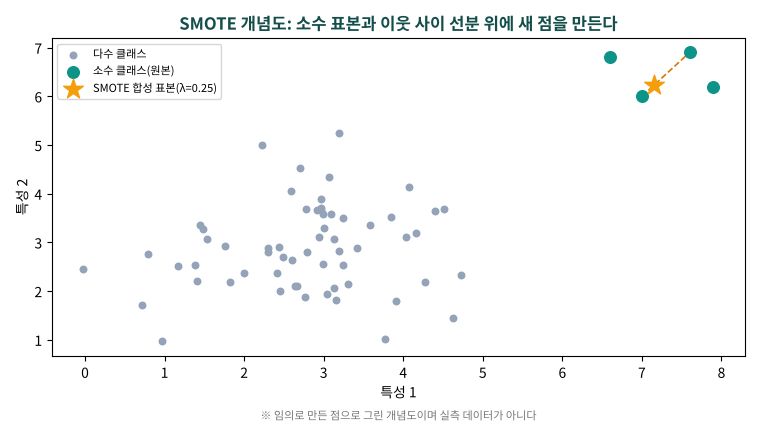
계산 예시다. x=(2, 3), 이웃 x’=(4, 7), λ=0.25이면 새 표본은 (2+0.25×2, 3+0.25×4)=(2.5, 4.0)이다. 두 점을 잇는 선분의 4분의 1 지점이라는 뜻이다.
클래스 가중치는 소수 클래스의 오류를 비싸게 만들어 같은 효과를 낸다
흔히 쓰는 가중치 공식은 전체 표본 수 ÷ (클래스 수 × 해당 클래스 표본 수)다. 위 데이터에서 이상 클래스는 1,000÷(2×20)=25, 정상 클래스는 1,000÷(2×980)≈0.51이다. 이상 한 건을 놓치는 손실이 정상 한 건을 놓치는 손실의 약 49배로 반영된다. 가중치 기본 설정은 라이브러리마다 다르므로 문서를 확인해야 한다.
답안에는 리샘플링을 학습 데이터에만 적용한다는 점과 평가지표 선택을 함께 쓴다
- 가장 흔한 실수는 데이터 전체를 먼저 오버샘플링한 뒤 분할하는 것이다. 합성된 표본이 검증 데이터에 섞여 성능이 부풀려진다(데이터 누수). 분할 후 학습 데이터에만 적용한다.
- 평가는 원래 분포의 검증 데이터에서 재현율·정밀도·F1·PR-AUC로 한다.
- 실무 연결: 오탐과 미탐의 비용이 다르므로 비용을 기준으로 임계값을 정한다. 예를 들어 사기 탐지는 미탐 비용이, 스팸 필터는 오탐 비용이 크다.
- 여러 기법을 섞어 쓰기도 한다(언더샘플링 + 앙상블, SMOTE + 가중치 등).
시험 직전 한 줄 요약
불균형 데이터에서는 정확도를 믿지 말고, 학습 데이터에만 샘플링·가중치로 균형을 맞추고, 평가는 원래 분포에서 재현율·F1로 한다.
이 글은 학습용 정리이며 실제 시험 문항과 다를 수 있다. 출제 기준은 한국데이터산업진흥원 등 공식 공지를 확인하라. 그림은 개념도이며 실측 데이터가 아니다.